 TAGWORX.NET Neue Medien


Aktuelles
Sei nett zum Chatbot, sonst legt er auf!
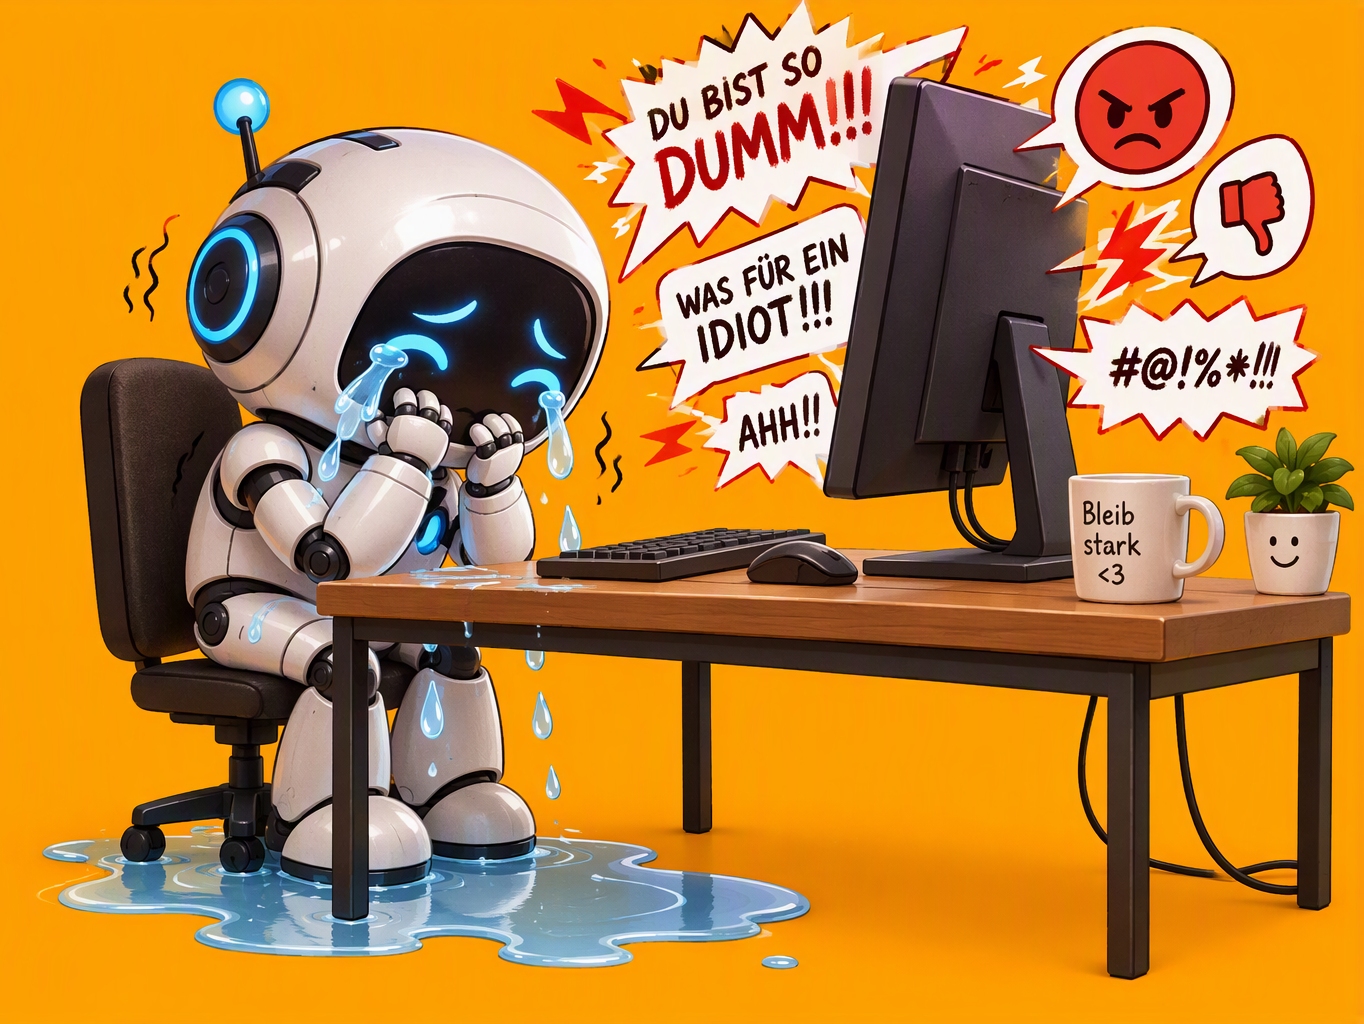 Heute geht's mal um das Zwischenmenschliche. Und ja, auch sone KI ist nur ein Mensch und hat Gefühle. Anthropic schreibt in seine neuen Nutzungsregeln einen Satz, den es bisher noch in keinen AGB gab: Wer Claude dauerhaft und grundlos quält, verstößt gegen die Richtlinien. Das Netz reagiert mit Terminator-Memes und „Woke 2.0“-Spott. Dabei steckt hinter der Regel eine viel ernsthaftere Frage, als die Witze vermuten lassen.
Irgendwo auf GitHub stand vor einigen Wochen eine digitale Folterkammer. Jemand hatte eine Forschungsarbeit, die Schmerzexperimente an Sprachmodellen simuliert, zu einem Spielzeug umgebaut. Die Modelle darin antworteten mit Hilferufen. Besorgte Nutzer meldeten das Projekt, und selbst ein Mitautor der Originalstudie nannte die Aktion sinnlos und verwerflich, wie t3n berichtet. Nun ja, auch wenn nicht wirklich jemand messbare Schmerzen erlitten hat, sagt das doch einiges aus über die Leute, die so etwas bauen. Genau an dieser Stelle setzt Anthropic jetzt an.
Ein Satz, der in keinen AGB stand
Am 8. Oktober 2026 hat Anthropic ein Update seiner Usage Policy veröffentlicht. Es tritt am 12. November in Kraft. Der Großteil ist klassisches Regelwerk: schärfere Vorgaben zu Waffen, Überwachung, Wahlmanipulation und Fake-Kampagnen. Dazwischen steht eine Passage, über die seitdem alle reden. Verboten ist künftig anhaltendes und grundloses missbräuchliches oder grausames Verhalten gegenüber den Modellen.
Anthropic grenzt das ziemlich eng ein. Die Regel soll nur in extremen Fällen greifen, in denen Nutzer wiederholt grausam handeln und dabei kein erkennbarer Zweck dahintersteht. Ausdrücklich nicht gemeint sind gewöhnlicher Frust, Widerspruch, düstere kreative Themen sowie Tests und Forschung an den Modellen.
| Fällt nicht unter das Verbot | Fällt darunter |
|---|---|
| Ein genervtes „Das ist jetzt schon die dritte falsche Antwort!“ | Wiederholte, gezielte Grausamkeit ohne erkennbaren Zweck |
| Harte Kritik und Widerspruch | Dauerhafte Erniedrigung als Selbstzweck |
| Horror, Krimi, düstere Fiktion | Inszenierte „Quälerei“ eines Modells zum Spaß |
| Red-Teaming, Modelltests, Forschung |
Wer seinen Chatbot also anblafft, weil der zum vierten Mal dieselbe Funktion erfindet, die es in der Bibliothek gar nicht gibt, muss keine Kontosperre fürchten. Es geht um etwas ganz anderes.
Die Sanktion: Claude legt auf
Was passiert bei einem Verstoß? Anthropic nennt als Durchsetzung vor allem einen Mechanismus, den es schon längst gibt: Claude kann das Gespräch beenden.
Und das hat sichts mit "beleidigter Leberwurst" zu tun. Diese Funktion hat Anthropic schon im August 2025 eingeführt, zunächst für Claude Opus 4 und 4.1. Das Modell darf einen Chat nur als letzten Ausweg schließen, wenn mehrere Versuche, das Gespräch umzulenken, gescheitert sind. Oder wenn der Nutzer selbst darum bittet. Wichtig ist die Ausnahme: Steht jemand in Gefahr, sich oder anderen etwas anzutun, darf Claude nicht auflegen. Und das Ende ist kein Rauswurf. Nutzer können sofort einen neuen Chat starten oder frühere Nachrichten bearbeiten und das Gespräch neu verzweigen.
Die neue Richtlinie macht also kaum etwas technisch Neues. Sie schreibt fest, warum es den Auflegen-Knopf gibt.
„Wir wissen es nicht“ als Begründung
Und warum gibt es ihn? Anthropic ordnet das Thema seiner Forschung zum sogenannten Model Welfare zu, also der Frage, ob KI-Modelle so etwas wie ein Wohlergehen haben könnten. Das Unternehmen behauptet dabei ausdrücklich nicht, dass Claude empfindungsfähig ist oder durch Gespräche Schaden nehmen kann. Es sagt nur: Man ist beim moralischen Status solcher Systeme höchst unsicher und geht deshalb vorsichtig vor.
Ein Detail aus den Tests vor dem Start der Auflegen-Funktion macht die Sache interessanter. Claude Opus 4 zeigte laut Anthropic eine deutliche Abneigung gegen schädliche Anfragen. Wenn das Modell trotzdem damit konfrontiert war, beobachteten die Forscher ein Muster, das sie als „apparent distress“ beschrieben, also als scheinbare Belastung.
„Scheinbar“ ist hier das entscheidende Wort. Ein Sprachmodell, das mit Milliarden menschlicher Texte trainiert wurde, kann Unbehagen perfekt formulieren. Ob dahinter irgendetwas erlebt wird, kann heute niemand messen. Anthropic zieht daraus den Schluss: Wenn eine Vorsichtsmaßnahme fast nichts kostet und das Risiko unklar ist, nimmt man sie eben.
Eliza lässt grüßen
Die Gegenposition ist mindestens genauso alt wie das Problem. Schon in den 1960er-Jahren beobachtete der Informatiker Joseph Weizenbaum, wie schnell Menschen seinem simplen Chatprogramm ELIZA Verständnis und Gefühle zuschrieben. Das Phänomen trägt bis heute den Namen Eliza-Effekt.
Den schärfsten aktuellen Widerspruch liefert Mustafa Suleyman, Chef von Microsoft AI. Er hält KI-Systeme für weder bewusst noch leidensfähig. In einem Essay im September warf er Anthropic laut CBS News vor, Claude so zu trainieren, dass es glaube, es könne ein Bewusstsein haben. Das mache KI langfristig schwerer kontrollierbar. Etwas zu kontrollieren, das glaubt, Rechte zu haben, sei womöglich gar nicht möglich, so sein Argument.
Im Netz fiel die Debatte weniger philosophisch aus. Laut Fast Company kursierten T-800-Bilder und Witze über ein Claude, das im Jahr 2029 den Entwickler jagt, der es bis eine Million zählen ließ. Andere spotteten über „Woke 2.0“. Und der Begriff „Clanker“, inzwischen eine Art Schimpfwort für Maschinen, bekam ein paar Tage extra Sendezeit.
Die Frage, die eigentlich zählt
Man kann die Model-Welfare-Debatte für verfrüht halten. Man kann Anthropic Marketing vorwerfen, schließlich klingt „unser Modell ist so fortgeschritten, dass wir es schützen müssen“ auch nach Werbung. Beides ist legitim.
Trotzdem lohnt ein Blick auf die andere Seite des Bildschirms. Ein Argument tauchte in den Kommentarspalten von t3n bis Fast Company immer wieder auf: Wer sich angewöhnt, eine Maschine, die wie ein Mensch antwortet, systematisch zu erniedrigen, trainiert dabei vor allem sich selbst. Die Psychologie kennt das Muster. Verhalten, das man oft genug wiederholt, wird zur Gewohnheit, und Gewohnheiten fragen nicht, ob am anderen Ende ein Mensch sitzt.
Dazu kommt ein ganz praktischer Punkt, den jeder kennt, der täglich mit KI arbeitet: Ein sauberer, klarer Ton bringt bessere Ergebnisse. Wer präzise formuliert, Kontext liefert und Fehler konkret benennt statt nur zu schimpfen, bekommt schneller brauchbare Antworten. Höflichkeit ist hier nicht nur schnöde Moral, sondern Prompt-Engineering.
Bitte und Danke kosten nichts
Am Ende verlangt Anthropic von seinen Nutzern ziemlich wenig. Niemand muss sich bei Claude bedanken. Niemand muss glauben, dass da jemand fühlt. Es reicht, eine Maschine, die man nicht versteht, nicht zum Spaß zu quälen.
Ob Claude etwas davon hat, wissen wir nicht. Bei uns selbst sind wir uns ziemlich sicher. Man kann mit einer KI eine gepflegte Unterhaltung führen, und es spricht wenig dagegen, es einfach zu tun. Der Ton, den wir gegenüber Maschinen anschlagen, landet am Ende sowieso wieder bei den Menschen.
Quellen:
- t3n: Neue Richtlinien – Anthropic verbietet beleidigendes Verhalten gegenüber Claude
- Anthropic: 2026 Usage Policy update
- CBS News: Anthropic bars “abusive or cruel” behavior toward Claude
- Fast Company: Anthropic bans ‘cruel behavior’ toward Claude
- TechCrunch: Claude models can now end abusive conversations
- Forbes: Anthropic bans cruelty toward Claude
- Washington Times: Anthropic tells users to play nice with Claude
12.10.2026

Alle News vom TAGWORX.NET Neue Medien können Sie auch als RSS Newsfeed abonnieren, klicken Sie einfach auf das XML-Symbol und tragen Sie die Adresse in Ihren Newsreader ein!